Un serveur RAID qui passe soudainement en mode dégradé, un volume devenu inaccessible ou plusieurs disques signalés en erreur ne sont jamais des incidents à banaliser. Lors de pannes RAID, chaque redémarrage, reconstruction ou tentative de réparation mal exécutée peut réduire les chances de retrouver les données. La priorité n’est pas de remettre le serveur en ligne à tout prix. Il faut d’abord préserver ce qui reste.
Un RAID n’est pas une sauvegarde. Il améliore la disponibilité des données en répartissant ou en répliquant l’information sur plusieurs disques, mais il ne protège ni contre une mauvaise manipulation, ni contre une corruption logique, ni contre une panne simultanée. Lorsque l’ensemble devient instable, la méthode compte autant que la technologie.
Les premiers gestes devant des pannes RAID
Arrêtez les écritures sur le volume touché. Ne copiez pas de nouveaux fichiers, ne lancez pas d’utilitaire de nettoyage et ne réinstallez pas le système d’exploitation sur les disques du serveur. Une écriture peut écraser des structures essentielles à la reconstruction du RAID, notamment les métadonnées, les tables de partitions ou les informations de parité.
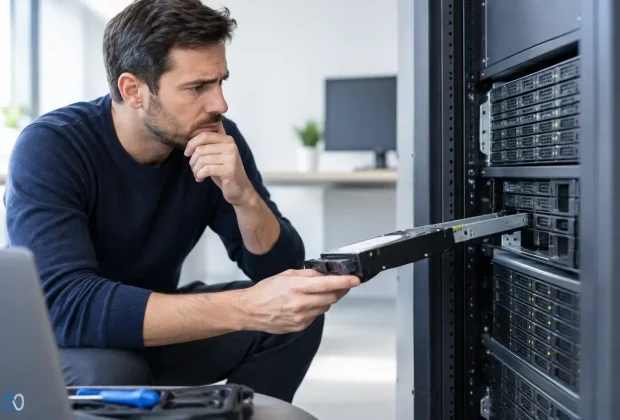
Si le contrôleur indique qu’un disque est défaillant, notez sa position exacte dans la baie avant de le retirer. Photographiez l’écran de gestion, les voyants des tiroirs et les messages d’erreur. L’ordre physique des disques est souvent déterminant pour reconstruire un RAID 0, RAID 5, RAID 6 ou RAID 10. Déplacer plusieurs disques sans les identifier transforme un incident technique en dossier beaucoup plus complexe.
Évitez surtout ces réflexes fréquents :
- forcer une reconstruction dès qu’un disque est remplacé;
- initialiser ou formater un volume proposé comme vierge par le système;
- exécuter des outils de réparation de système de fichiers sur les disques d’origine;
- échanger les disques de position sans repère précis;
- multiplier les redémarrages lorsqu’un disque émet des clics, grattements ou bruits anormaux.
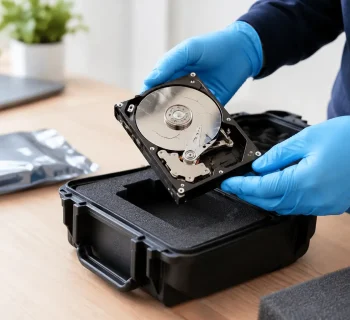
Un disque qui fait du bruit ne souffre pas d’un simple problème logiciel. Il peut présenter une défaillance mécanique interne. Dans ce cas, l’insistance risque d’endommager davantage les plateaux et de compliquer fortement la lecture des données en laboratoire.
Pourquoi un RAID peut tomber en panne
Les pannes RAID ne proviennent pas uniquement des disques. Un ensemble peut devenir inaccessible à cause du contrôleur RAID, d’une alimentation défectueuse, d’un câble, d’un micrologiciel instable ou d’une surtension. Une mise à jour interrompue, une configuration effacée ou une erreur humaine peut aussi faire disparaître un volume pourtant composé de disques encore fonctionnels.
La panne la plus connue reste la défaillance d’un ou de plusieurs disques. Dans un RAID 5, un seul disque peut normalement être perdu sans arrêter l’accès aux données. Mais si un deuxième disque commence à échouer pendant la reconstruction, l’ensemble devient indisponible. Le risque est particulièrement élevé avec des disques du même âge, installés en même temps et soumis à la même charge de travail.
Le RAID 6 tolère généralement la perte de deux disques, mais cette tolérance n’est pas absolue. Une corruption de parité, un mauvais ordre des disques, des secteurs illisibles sur plusieurs unités ou une reconstruction déclenchée sur le mauvais membre peuvent empêcher tout redémarrage normal. RAID 10 offre souvent une meilleure résistance aux pannes de disque, mais une perte de deux disques appartenant au même miroir peut aussi rendre le volume inaccessible.
Le RAID 0, pour sa part, ne fournit aucune redondance. Les données sont réparties entre les disques pour améliorer les performances. La panne d’un seul membre peut rendre l’ensemble des données illisible. Dans ce scénario, ne remplacez pas le disque et ne créez pas un nouveau volume : chaque disque doit être analysé comme une pièce d’un même puzzle.
La panne logique, souvent sous-estimée
Un RAID peut sembler en bon état matériel tout en étant inutilisable. Des dossiers disparaissent après un effacement accidentel, un partage réseau est vidé, une partition est supprimée ou le système de fichiers devient RAW. Une attaque par rançongiciel peut également chiffrer les données de tous les volumes accessibles, y compris les partages hébergés sur un serveur RAID.
Dans ces situations, le contrôleur peut afficher un état normal. Cela ne signifie pas que les données sont intactes. La bonne démarche consiste à isoler le système, préserver les disques et éviter toute opération qui écrit sur le volume. La récupération dépend alors de l’état réel des structures logiques et de la quantité de données déjà écrasées.
Les symptômes qui exigent un arrêt immédiat
Certains signes doivent interrompre les essais internes. Un message indiquant plusieurs disques hors ligne, une reconstruction bloquée depuis des heures, des erreurs de lecture répétées ou un volume qui monte puis disparaît sont des alertes sérieuses. Il en va de même lorsqu’un NAS propose d’initialiser les disques ou de recréer le groupe de stockage.
Un contrôleur RAID défectueux peut aussi afficher des informations incohérentes : capacité erronée, niveau RAID modifié, disques déclarés vierges ou ordre des membres inconnu. Remplacer le contrôleur par un modèle semblable peut parfois aider, mais ce n’est pas une solution universelle. Les paramètres de configuration, la version du micrologiciel et les métadonnées enregistrées sur les disques doivent correspondre. Une incompatibilité peut provoquer une initialisation ou une écriture destructrice.
Les équipes TI ont parfois raison de tenter une intervention interne, notamment lorsqu’elles disposent de sauvegardes vérifiées, d’un disque unique clairement défaillant et d’une procédure documentée par le fabricant. Mais lorsqu’il n’existe pas de copie récente, que plusieurs disques sont en cause ou que les données soutiennent les opérations de l’entreprise, il faut cesser les essais. Le coût d’un diagnostic spécialisé est généralement inférieur au coût d’une perte définitive, d’un arrêt de production ou d’une restauration impossible.
Comment se déroule une récupération RAID sérieuse
Une récupération fiable commence par un diagnostic. Il ne s’agit pas seulement de brancher les disques et de chercher les fichiers. Il faut identifier le type de RAID, le nombre de membres, leur ordre, la taille des bandes, le sens de rotation, les décalages de données, le système de fichiers et l’état physique de chaque support.
Lorsque des disques sont instables ou mécaniquement endommagés, les spécialistes créent d’abord des copies sectorielles de travail. Les opérations de reconstruction sont ensuite effectuées sur ces copies, jamais en modifiant les originaux. Cette précaution permet de tester différentes configurations sans mettre en danger les données restantes.
Dans les cas de panne mécanique, une intervention en salle blanche peut être nécessaire pour stabiliser le disque et extraire une image exploitable. Une salle blanche certifiée ISO 5 classe 100 limite les risques de contamination lors des manipulations internes. Ce travail n’est pas comparable à un logiciel de récupération téléchargé en urgence : il repose sur l’analyse des supports, l’électronique, la mécanique et la logique RAID.
Après reconstruction virtuelle, les données récupérables sont vérifiées. Pour une entreprise, cette étape doit cibler les éléments qui permettent de reprendre l’activité : machines virtuelles, bases de données, fichiers comptables, projets, courriels ou partages critiques. Pour un particulier, ce seront souvent les photos, vidéos, archives et documents personnels irremplaçables.
Prévenir la prochaine défaillance sans créer un faux sentiment de sécurité
Après une récupération, il faut corriger la cause de l’incident. Remplacer les disques usés est nécessaire, mais insuffisant. Vérifiez la ventilation, l’alimentation sans coupure, les alertes SMART, le micrologiciel du NAS ou du contrôleur et la surveillance de l’état RAID. Testez aussi la procédure de remplacement d’un disque avant qu’une urgence survienne.
Surtout, mettez en place des sauvegardes séparées du serveur. Une copie stockée sur le même RAID ne constitue pas une sauvegarde. Conservez au moins une copie hors ligne ou hors site et testez régulièrement sa restauration. La meilleure stratégie dépend de la taille des données, du délai de reprise acceptable et des obligations de votre organisation, mais une sauvegarde non testée reste une promesse, pas une protection.
Devant un RAID inaccessible, la décision la plus utile est souvent la plus calme : arrêter les écritures, documenter l’état du système et confier l’analyse à des techniciens qui travaillent sur les copies plutôt que sur les originaux. Chez Chronodisk, ce type de dossier est évalué avant toute intervention afin que la méthode choisie protège d’abord vos chances de récupération. Vos données n’ont pas besoin d’un geste précipité. Elles ont besoin de la bonne intervention.